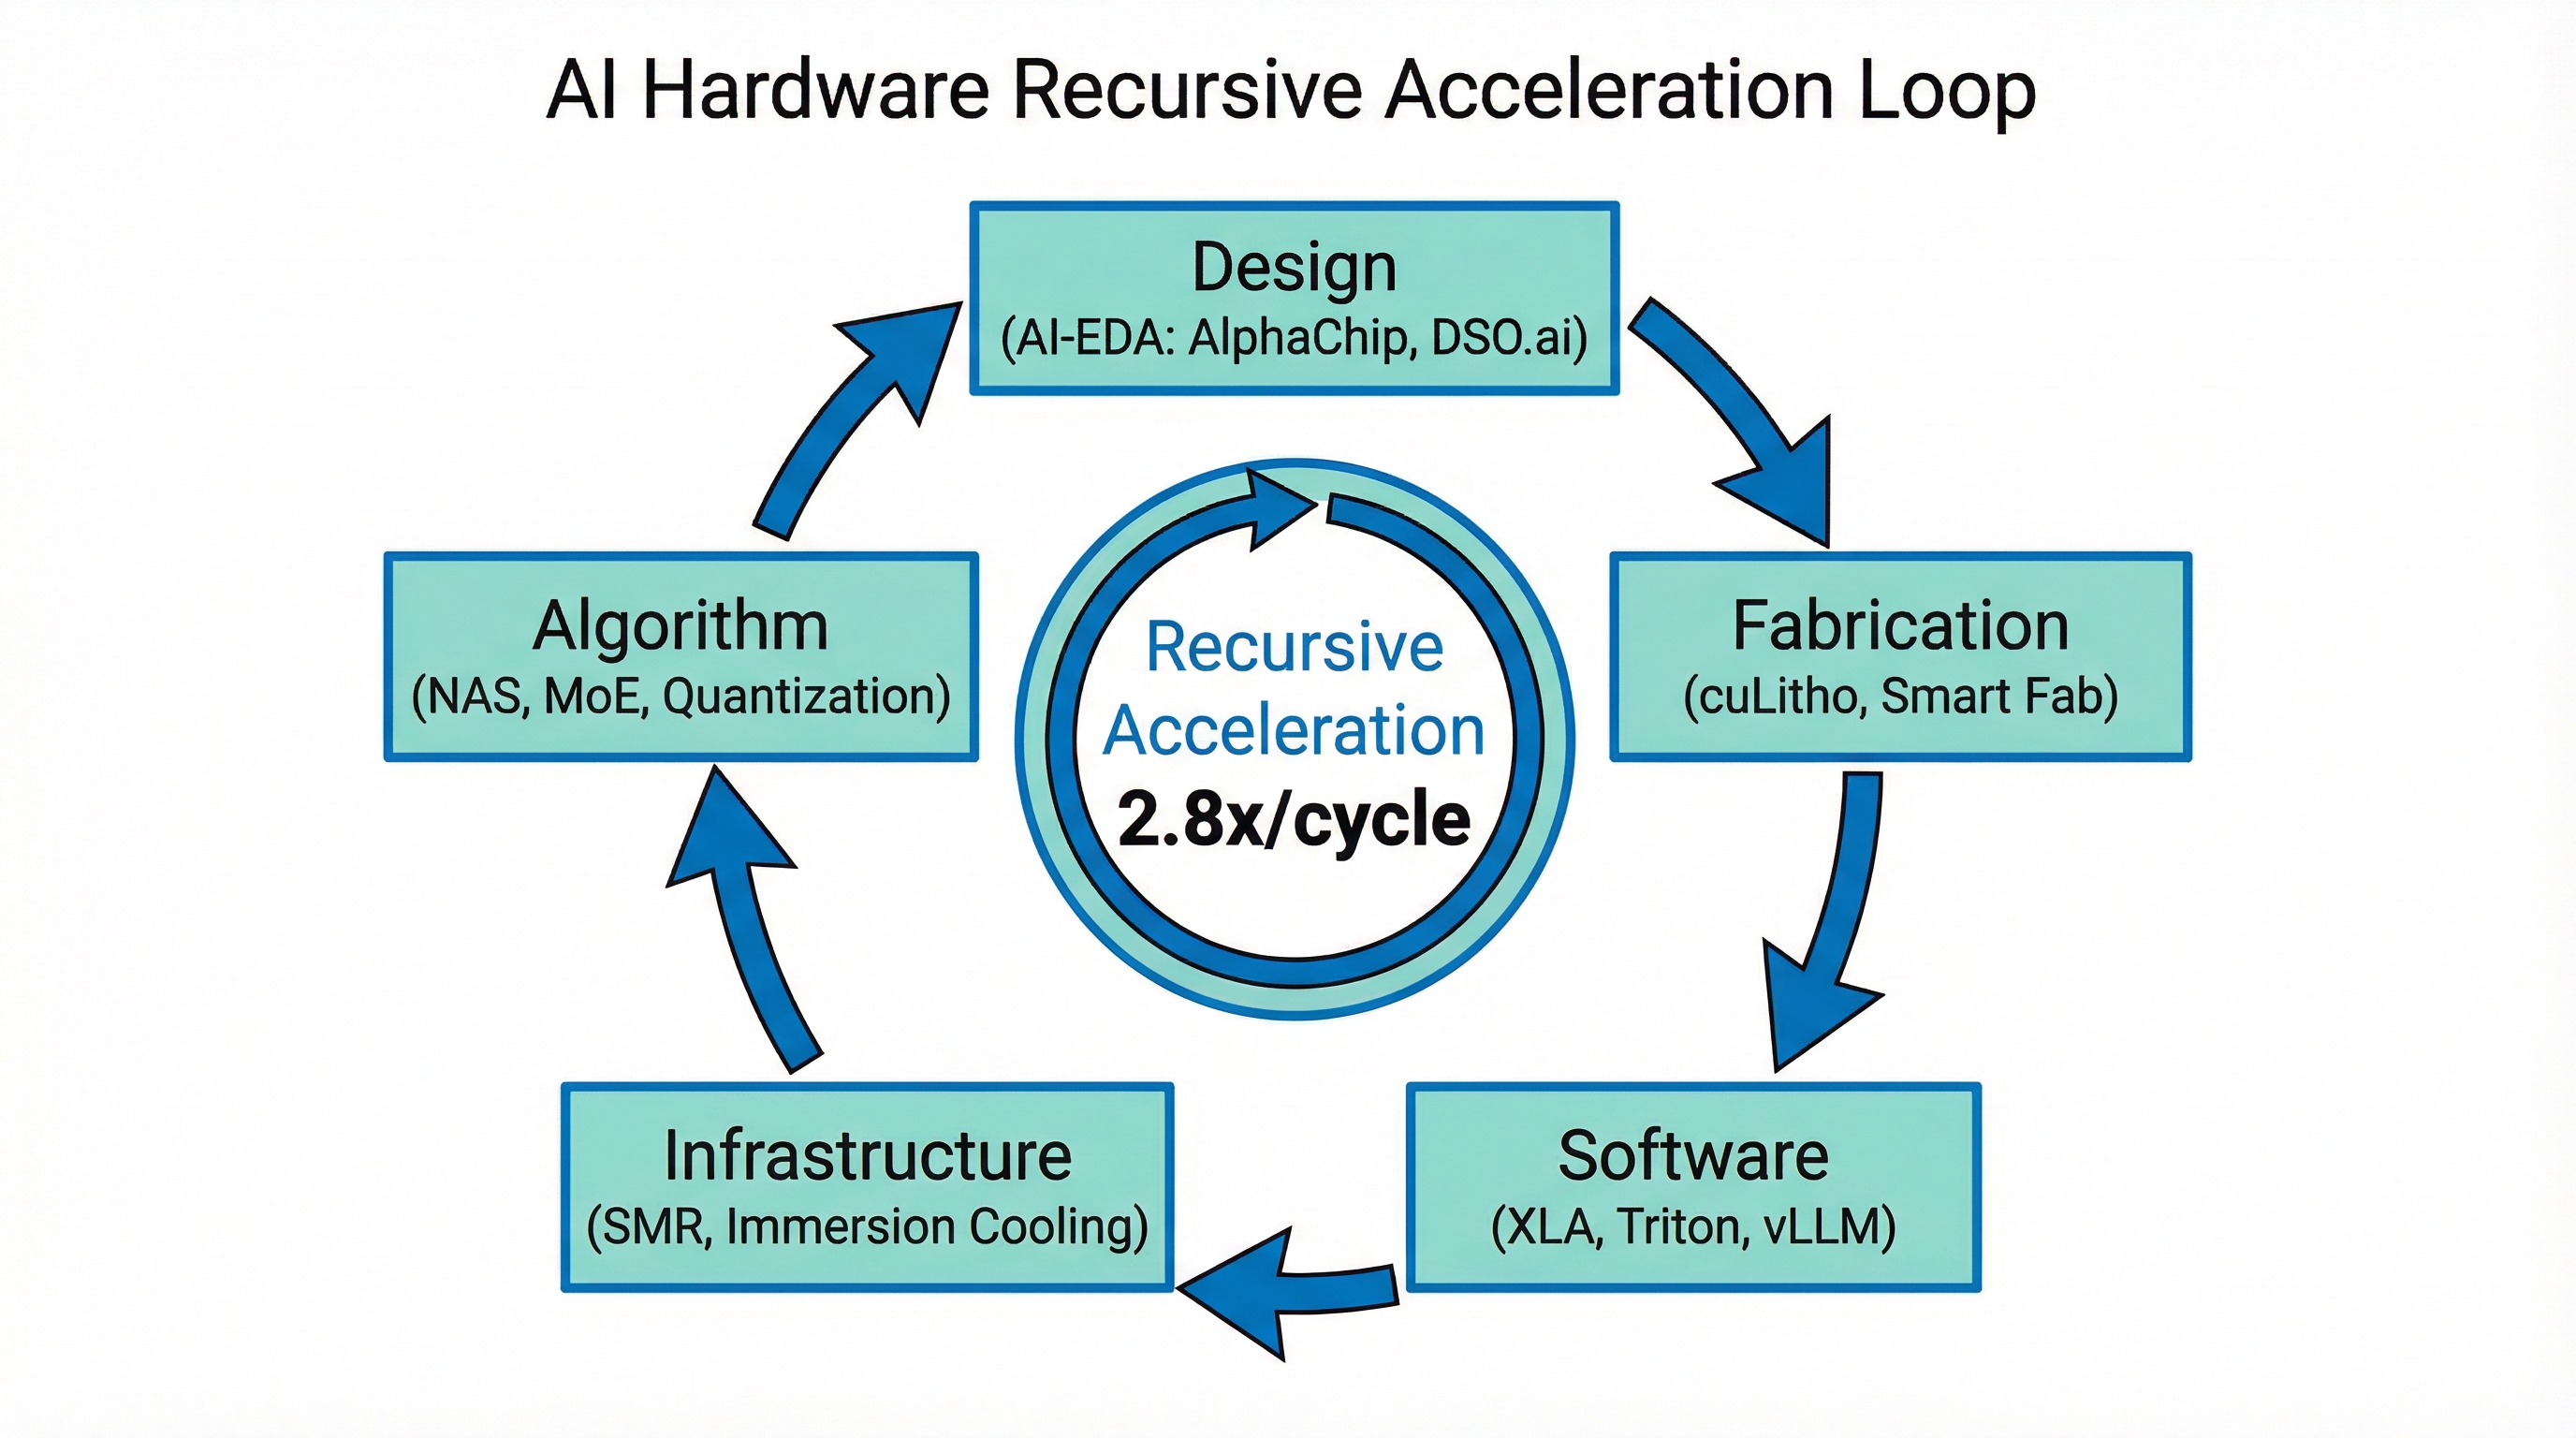
Figure 1. AI 하드웨어 재귀 가속 루프의 5대 계층 프레임워크. 설계(3.2x), 제조(1.8x), 소프트웨어(2.8x), 인프라(2.0x), 알고리즘(4.0x) 계층이 상호 피드백을 형성하며, 세대당 복합 가속 배율 2.8x를 달성한다.
본 논문은 AI 하드웨어 발전의 재귀 가속 루프를 설계, 제조, 소프트웨어, 인프라, 알고리즘의 5대 계층 프레임워크로 체계화하고, 각 계층의 실증 데이터를 분석한다. 현재 총 재귀 가속 배율은 세대당 2.8배이며, 14개월 주기로 순환한다. 특히 알고리즘(4.0x)과 설계(3.2x) 계층의 급속 가속이 제조 계층(1.8x)의 물리적 둔화를 상쇄하고 있다. NVIDIA A100에서 Rubin R100까지 5년간 에너지 효율이 26.7배 향상된 실증 데이터를 바탕으로, 본 연구는 향후 5–7년간 세대당 가속 배율이 3.5–5.0배에 도달하는 '초가속(Super-Acceleration)' 체제의 형성을 전망한다.
This paper systematically analyzes the recursive acceleration loop in AI hardware development through a five-layer framework encompassing design, fabrication, software, infrastructure, and algorithm. The current compound recursive acceleration stands at 2.8x per generation with a 14-month cycle. Notably, rapid acceleration in the algorithm (4.0x) and design (3.2x) layers offsets the physical slowdown in fabrication (1.8x). Based on empirical data showing a 26.7x improvement in energy efficiency from NVIDIA A100 to Rubin R100 over five years, we project a 'Super-Acceleration' regime where per-generation acceleration reaches 3.5–5.0x within the next 5–7 years.
Keywords: AI Hardware, Recursive Acceleration, Chip Design, Semiconductor, Super-Acceleration, Feedback Loop, Moore's Law
1965년 Gordon Moore가 집적회로의 트랜지스터 수가 약 2년마다 두 배로 증가한다고 예측한 이래[10], 무어의 법칙은 반세기 이상 반도체 산업의 로드맵으로 기능해왔다. Robert Dennard의 스케일링 법칙[11]은 트랜지스터 미세화와 함께 전력 밀도가 일정하게 유지된다는 이론적 토대를 제공했다. 그러나 2006년경 데나드 스케일링의 종말 이후, 단순한 미세화를 통한 성능 향상은 급격히 둔화되었다.
이러한 한계에도 불구하고 AI 하드웨어 분야에서는 놀라운 가속이 관찰된다. 2026년 기준 글로벌 반도체 산업 매출은 $975B에 달하며, AI 칩이 매출의 50%를 차지한다[18][20]. 이 가속의 핵심 동력은 AI와 하드웨어 사이의 상호 강화 관계에 있다. AI가 칩 설계를 최적화하고, 개선된 칩이 더 강력한 AI를 가능케 하며, 그 AI가 다시 차세대 칩을 설계하는 재귀적 피드백 루프가 형성되어 있다.
본 논문은 이 '재귀 가속 루프(Recursive Acceleration Loop)'를 체계적으로 분석한다. 논문의 주요 기여는 세 가지다. 첫째, AI 하드웨어 가속의 5대 계층 프레임워크를 제시한다. 둘째, 각 계층의 실증 데이터를 기반으로 가속 배율을 정량적으로 분석한다. 셋째, 이 복합 재귀 구조가 형성할 '초가속(Super-Acceleration)' 체제의 전망과 리스크를 논의한다.
무어의 법칙[10]은 경험적 관찰에서 출발하여 산업 전체의 자기실현적 예언(self-fulfilling prophecy)으로 작동했다. 트랜지스터 수는 1965년 이래 지수적으로 증가하여 현재 NVIDIA B200의 경우 단일 다이에 2,080억 개의 트랜지스터를 집적한다. 데나드 스케일링[11]은 전압과 전류가 크기에 비례하여 줄어드므로 전력 밀도가 일정하다고 설명했으나, 2006년경 누설 전류 문제로 인해 사실상 종료되었다. 이후 멀티코어, 이종 컴퓨팅, 도메인 특화 가속기(DSA)로의 패러다임 전환이 이루어졌다.
AI 가속기의 성능 향상 속도는 무어의 법칙을 압도한다. NVIDIA A100(2020)의 FP16 312 TFLOPS에서 Rubin R100(2026)의 FP8 25,000 TFLOPS까지, 5년 만에 연산 성능이 80배 이상 증가했다. 에너지 효율은 0.78 TFLOPS/W에서 20.83 TFLOPS/W로 26.7배 향상되었다. 메모리 대역폭도 HBM2e의 460 GB/s에서 HBM4의 1,800 GB/s로 3.9배 확대되었다[12]. Google의 TPU는 v4(BF16 275 TFLOPS, 2021)에서 v7 Ironwood(4.6 PFLOPS, 2025)까지 4년 만에 16.7배의 성능 향상을 달성했다. AMD 역시 MI300X(2023)에서 MI500(2026)까지 1,000배 AI 성능 향상을 목표로 하고 있다.
전통적인 가속 패러다임은 개별 기술의 선형적 개선에 의존했다. 공정 미세화, 아키텍처 혁신, 소프트웨어 최적화가 각각 독립적으로 기여하는 모델이었다. 그러나 현재 관찰되는 가속은 이러한 선형 모델로 설명하기 어렵다. AI가 각 계층에 투입되어 계층 간 상호 강화가 일어나는 재귀적 구조를 이해해야만 현재의 가속을 올바르게 설명할 수 있다.
본 논문은 AI 하드웨어의 재귀 가속을 5대 계층으로 구조화한다(Figure 1). 각 계층은 독립적으로 가속을 제공하면서 동시에 다른 계층의 가속을 촉진하는 피드백 루프를 형성한다. 이 프레임워크의 핵심은 복합 가속 모델에 있다. 총 가속 배율은 각 계층별 가속의 곱으로 표현된다:
Atotal = Adesign × Afab × Asw × Ainfra × Aalgo
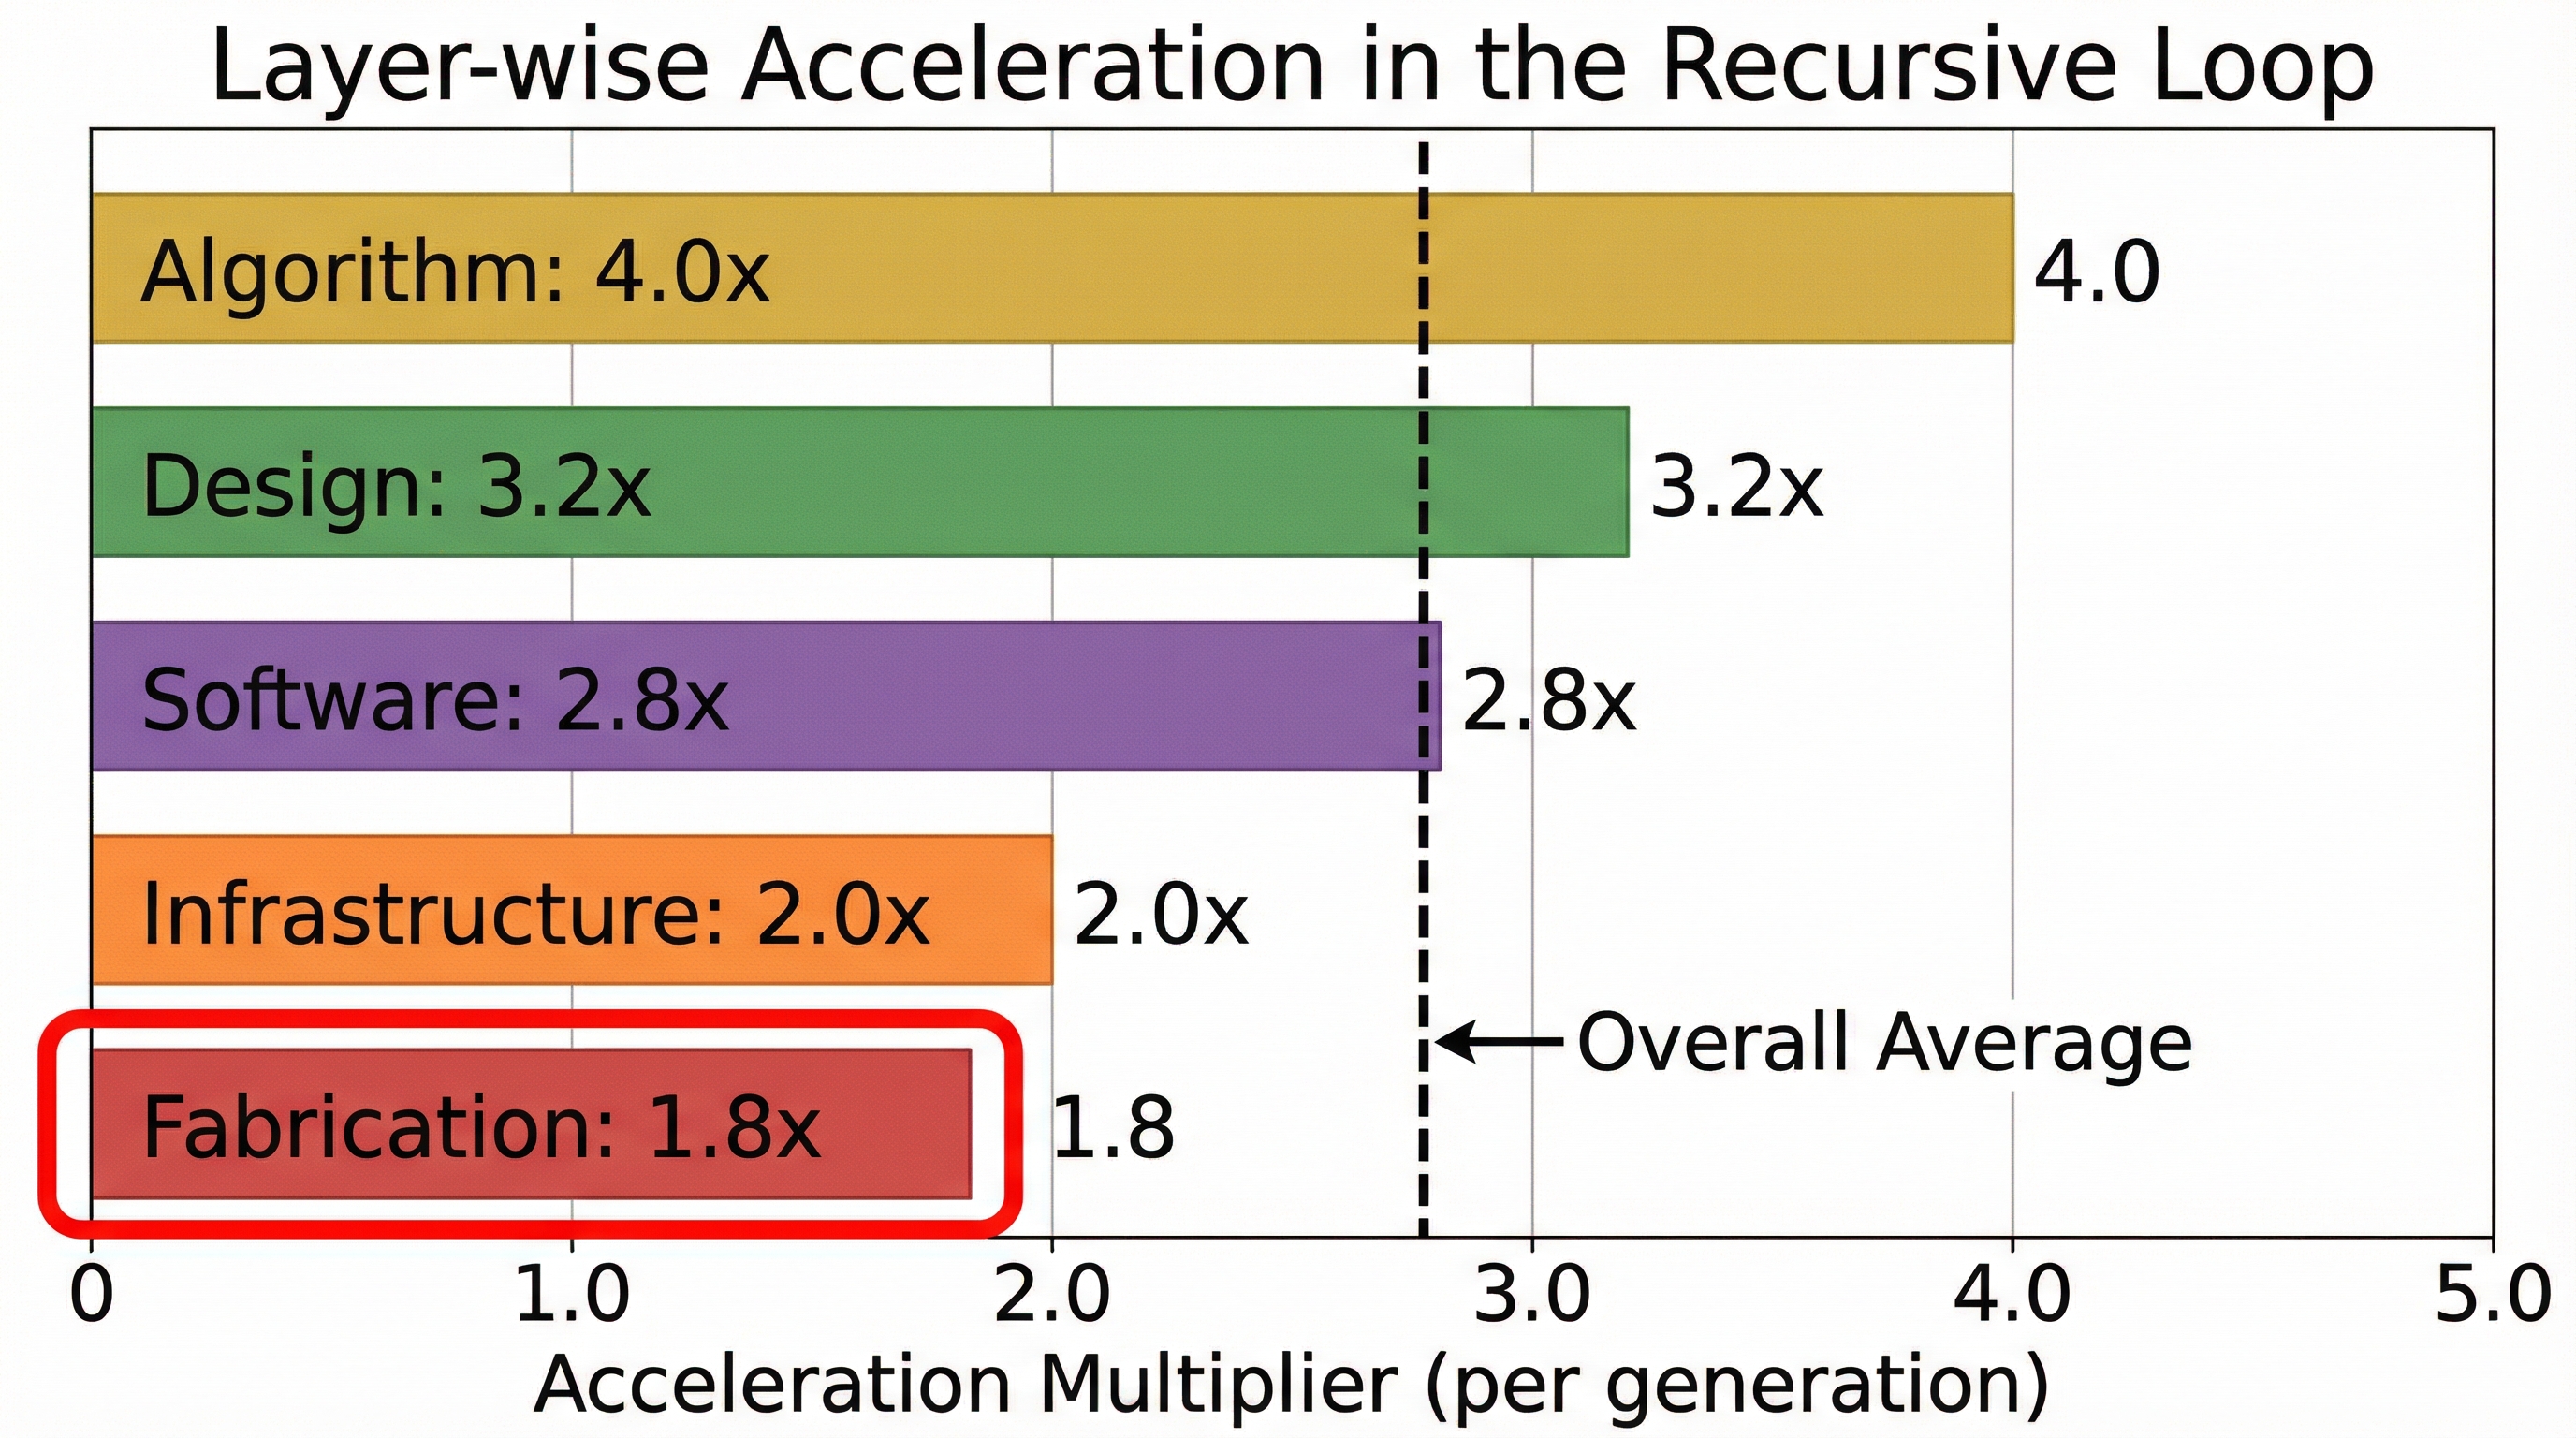
그러나 실제 관측되는 세대당 가속(2.8x)은 단순 곱(3.2 × 1.8 × 2.8 × 2.0 × 4.0 = 115x)보다 현저히 낮다. 이는 계층 간 중복 효과, 직렬 의존성, 그리고 병목 계층의 제약이 복합적으로 작용하기 때문이다. 특히 제조 계층(1.8x)이 주요 병목으로 작용하여 다른 계층의 잠재적 가속이 완전히 실현되지 못한다.
각 계층은 14개월의 주기로 순환하며, 이전 세대의 출력이 다음 세대의 입력으로 투입되는 재귀 구조를 이룬다. 이 구조에서 가장 주목할 점은 가속이 가속을 낳는 자기강화(self-reinforcing) 특성이다. AlphaChip이 설계한 TPU가 더 강력한 AlphaChip을 훈련시키고, 그 AlphaChip이 다시 더 나은 TPU를 설계하는 루프가 3세대(v5→v6→Ironwood)에 걸쳐 실증되었다[1][2].
| 계층 | 가속 배율 | 추세 | 주요 기술 |
|---|---|---|---|
| 설계 | 3.2x | 가속 중 | AlphaChip, DSO.ai, Cerebrus |
| 제조 | 1.8x | 둔화 중 | cuLitho, AI 수율예측, EUV |
| 소프트웨어 | 2.8x | 가속 중 | XLA, Triton, vLLM, TensorRT |
| 인프라 | 2.0x | 안정 | SMR 원자로, 액침냉각, NVLink |
| 알고리즘 | 4.0x | 가속 중 | MoE, 양자화, NAS, 증류 |
AI 기반 칩 설계는 가장 직접적인 재귀 루프를 형성한다. Google의 AlphaChip은 강화학습을 이용하여 칩 플로어플래닝을 수시간 만에 완료하며, 인간 전문가 대비 배선 길이를 6.2% 단축한다[1][2]. TPU v5에서 v6(Trillium), 그리고 v7(Ironwood)까지 3세대 연속으로 설계에 적용되어 완전한 자기강화 루프가 실증되었다. Trillium에서는 25개 모듈의 레이아웃을 AlphaChip이 설계했다.
Synopsys의 DSO.ai는 1020 규모의 설계 공간에서 최적 PPA(성능/전력/면적)를 자동 탐색하여 생산성을 3배 이상 향상시킨다[4]. 2025년에는 GenAI Copilot과 AgentEngineer로 확장되어 RTL 생성과 자율 설계 워크플로우를 지원한다. Cadence의 Cerebrus 역시 AI 기반 설계 자동화를 제공하며, NVIDIA Rubin과 AMD MI500 등 차세대 칩 모두가 AI 설계 도구를 활용하고 있다. 칩 설계 시간이 수개월에서 수시간으로 100배 이상 단축된 것은 설계 계층의 재귀 가속이 실질적으로 작동하고 있음을 보여준다.
제조 계층은 현재 5대 계층 중 유일한 병목이다. NVIDIA의 cuLitho는 컴퓨테이셔널 리소그래피를 GPU로 40배 가속하며, 500대 DGX H100이 40,000대 CPU 시스템을 대체한다[3]. 생성형 AI 워크플로우 추가로 80배 가속이 달성되었다. TSMC의 AI 스마트팹은 장비 제어, 실시간 디스패칭, 결함 검출을 AI 에이전트가 수행하며, OEE를 15% 이상 향상시키고 운영비를 25–30% 절감한다[17].
그러나 공정 미세화는 물리적 한계에 접근하고 있다. TSMC N2(2nm) GAA 나노시트 기술이 2025년 말 양산을 개시했으나, 이후 A16(백사이드 전력공급), A14(1.4nm) 등 근본적 구조 변화가 필요하다. 트랜지스터 스케일링은 약 3세대(~5년)의 여유만 남아 있으며, 이론적 한계인 ~0.5nm에 근접하고 있다. 최첨단 팹 건설비가 $200억을 초과하고 건설 기간이 3–5년 소요되는 경제적 제약도 심화되고 있다. CoWoS 어드밴스드 패키징 용량 부족으로 Google TPU 생산 목표가 하향 조정된 사례는 제조 병목의 심각성을 보여준다.
소프트웨어 계층은 동일 하드웨어에서 2–3배의 성능 향상을 달성하는 핵심 가속 계층이다. Google의 XLA/OpenXLA는 연산 그래프 퓨전으로 1.5–3배 성능을 향상시키며[5], NVIDIA, AMD, Google, Apple, Meta가 공동 개발에 참여하고 있다. Stanford Hazy Research의 ThunderKittens 2.0은 Blackwell GPU를 네이티브 지원하며, 어텐션 backward 10–40%, SSM 8배, 선형 어텐션 14배의 성능 가속을 달성한다[6][7].
추론 최적화 분야에서 vLLM은 PagedAttention 기반의 효율적 메모리 관리로 LLM 서빙 처리량을 3–5배 향상시킨다[8]. NVIDIA의 TensorRT-LLM은 H100 FP8에서 10,000+ 토큰/초를 달성하며[9], TTFT(Time-to-First-Token) 35–50ms의 초저지연 추론을 제공한다. 특히 주목할 점은 TritonForge 등 AI가 직접 GPU 커널을 생성하는 방향으로 진화하고 있다는 것이다. 이는 소프트웨어 계층의 재귀 루프가 더욱 강화될 것임을 시사한다.
AI 데이터센터의 전력 수요는 460 TWh(2024)에서 1,300 TWh(2035)로 급증할 전망이다[19]. 이에 대응하여 빅테크 기업들이 10 GW 이상의 원자력 계약을 체결하고 있다. Microsoft는 $16B 규모의 TMI 원전 재가동(835 MW, 2027년 목표), Google은 Kairos Power와 500 MW SMR 계약, Amazon은 X-energy에 $500M을 투자하여 5 GW(2039년)를 확보하는 등 에너지 인프라의 대규모 전환이 진행 중이다.
냉각 기술 역시 혁신적으로 발전하고 있다. B200의 1,000W TDP는 에어쿨링 한계(~600W)를 초과하여 모든 차세대 AI 서버가 액체/액침냉각을 필수로 한다. GRC ICEraQ는 시스템당 368 kW 냉각과 PUE 1.03을 달성하며, 액침냉각 시장은 $2.8B(2025)에서 $21B+(2032)로 성장할 전망이다. 인터커넥트 분야에서는 NVLink 3.0(600 GB/s)에서 5.0(1,800 GB/s)으로 세대당 약 2배의 대역폭 향상이 이루어졌으며, Co-Packaged Optics(CPO)가 차세대 기술로 개발 중이다.
알고리즘 계층은 5대 계층 중 가장 높은 가속 배율(4.0x)을 기록한다. Mixture of Experts(MoE)는 동일 연산량 대비 모델 용량을 4–8배 확장하며[15], 활성 파라미터만 선택적으로 연산하여 효율성을 극대화한다. FP8/FP4 양자화는 메모리와 연산을 2–4배 절감하며[16], Neural Architecture Search(NAS)는 1020 규모의 탐색 공간에서 최적 아키텍처를 자동 발견한다[13][14].
투기적 디코딩(Speculative Decoding)은 추론을 2–3배 가속하며, 지식 증류(Distillation)를 통해 소형 모델이 대형 모델 성능의 90% 이상을 달성한다. 알고리즘 효율은 매년 약 2배씩 개선되어 하드웨어 스케일링을 보완하는 역할을 한다. 이는 동일한 하드웨어 자원으로 매년 두 배의 AI 성능을 추출할 수 있음을 의미하며, 제조 계층의 둔화를 상쇄하는 핵심 동력이다.
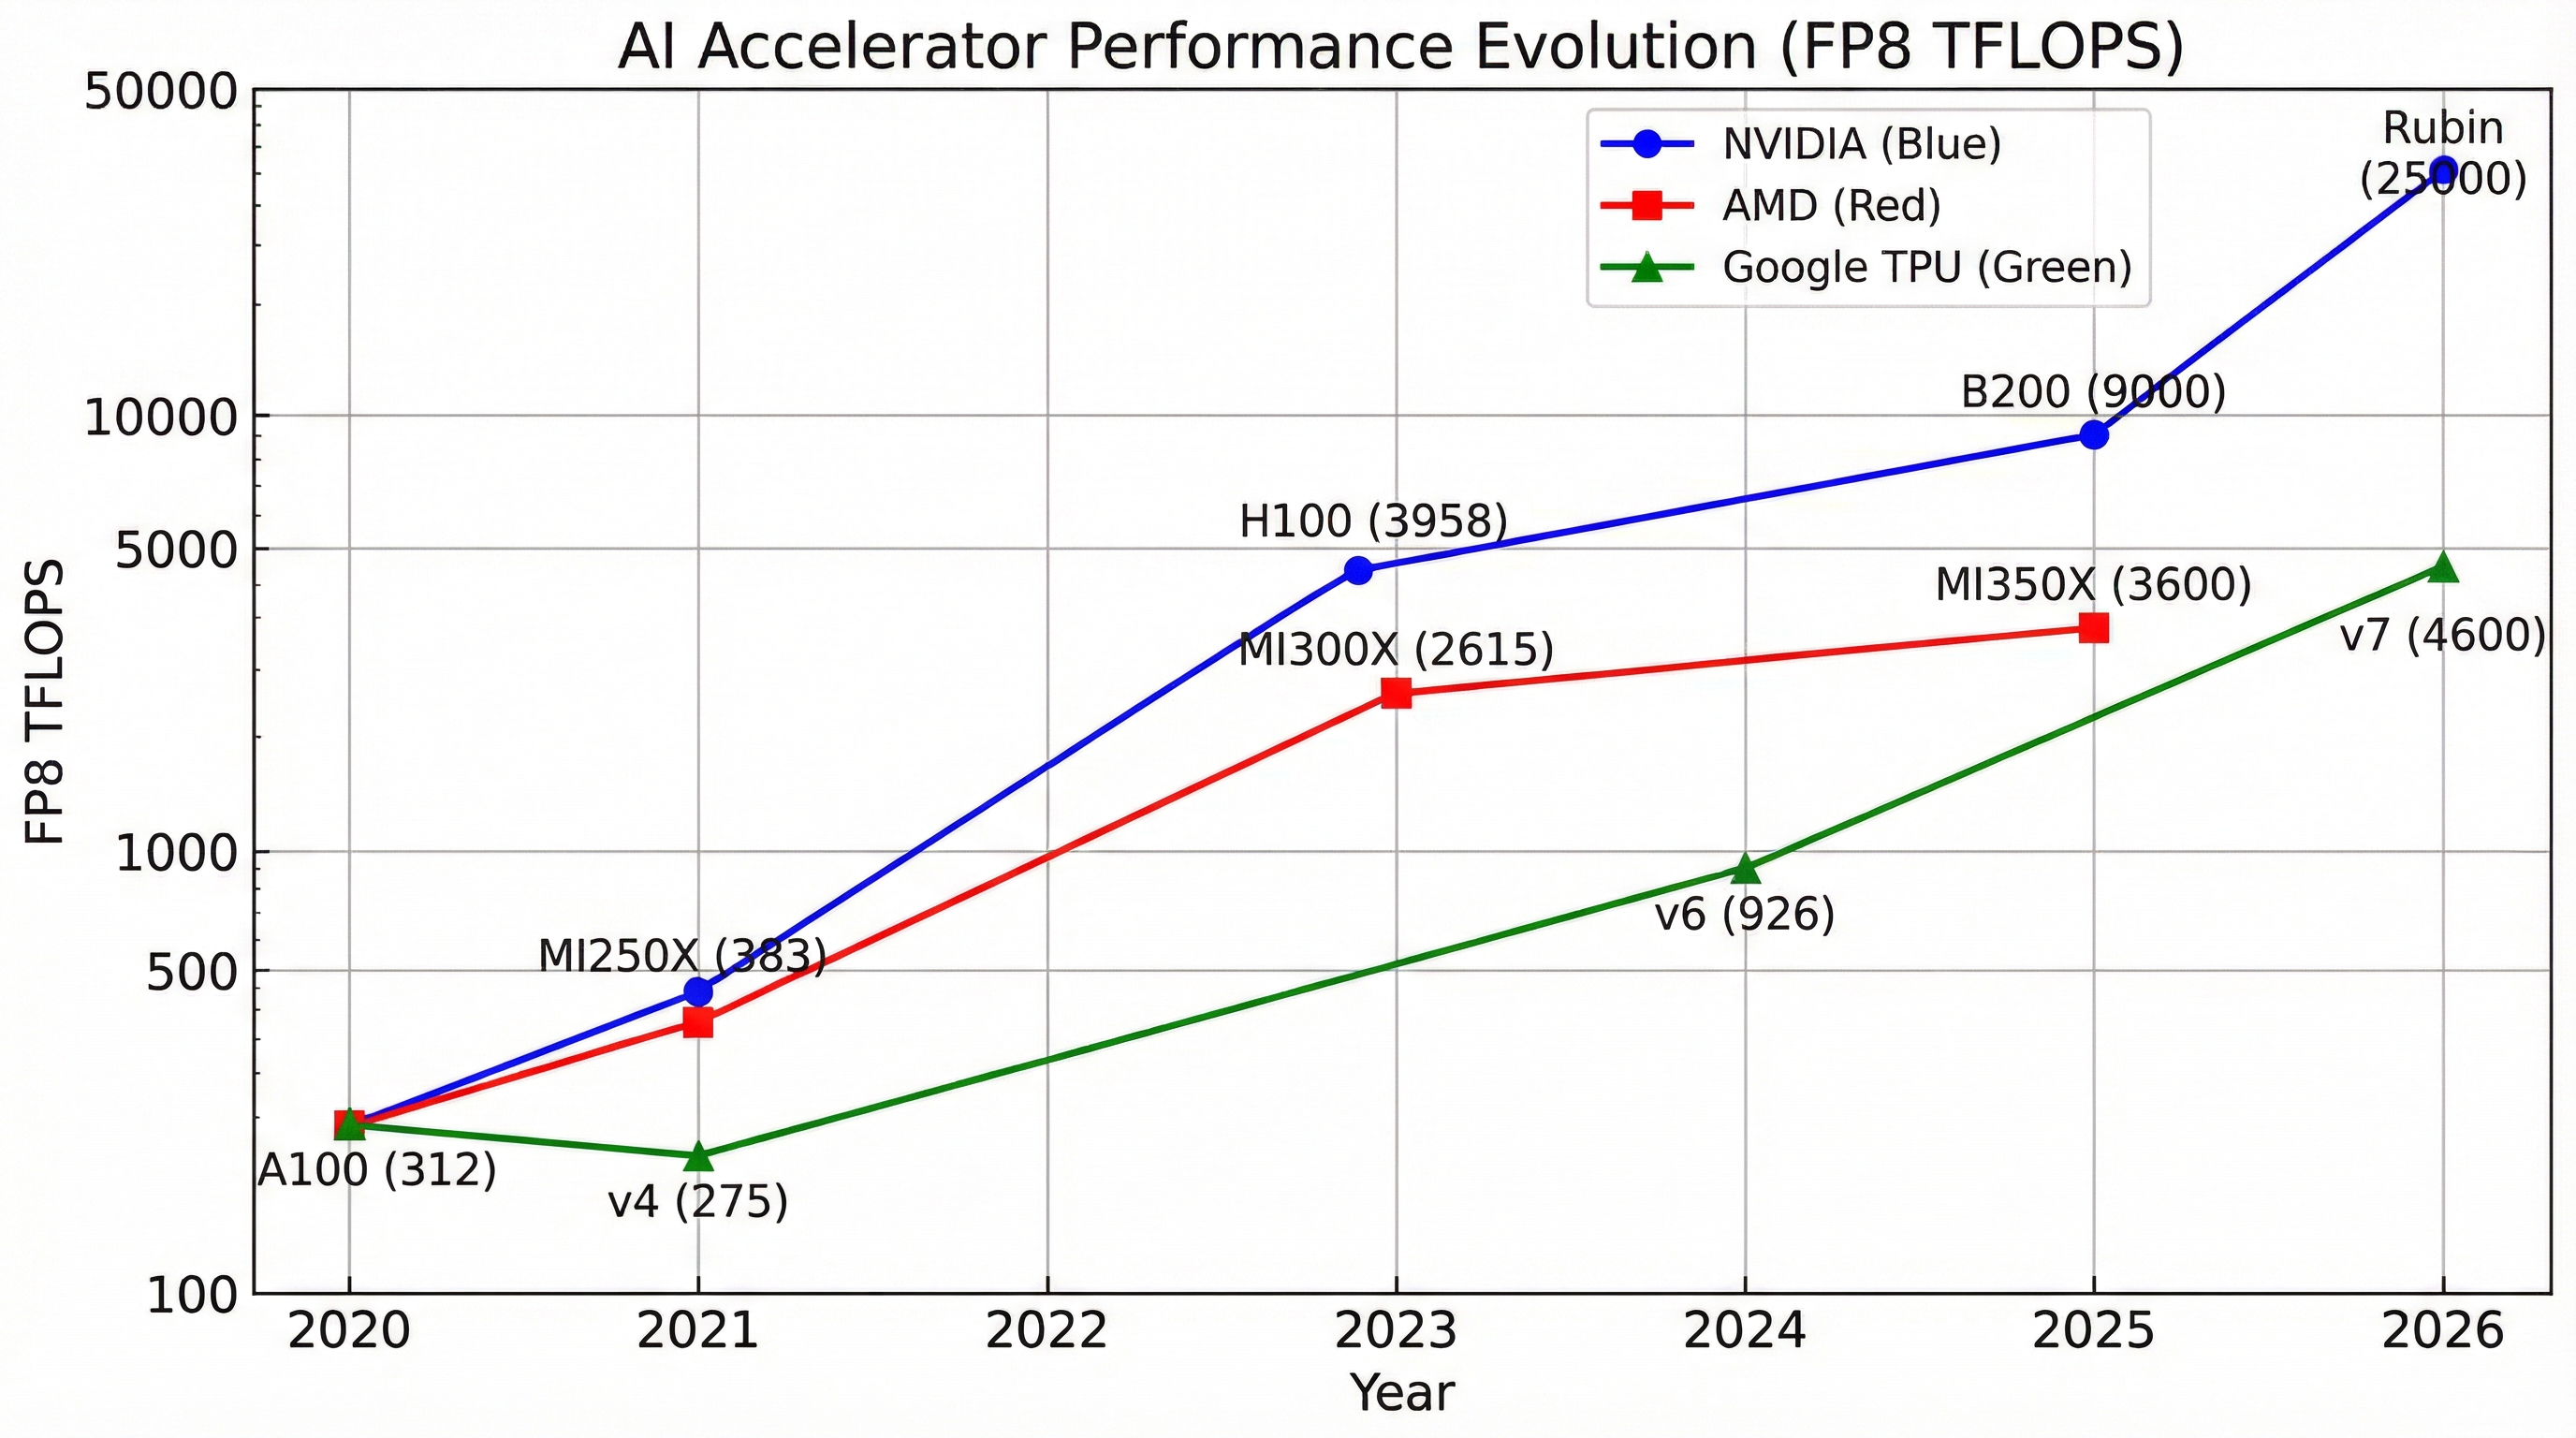
| 세대 | 연도 | FP8 (TFLOPS) | 메모리 | BW (TB/s) | TDP (W) | 효율 (TFLOPS/W) |
|---|---|---|---|---|---|---|
| A100 | 2020 | — | HBM2e 80GB | 2.0 | 400 | 0.78* |
| H100 | 2022 | 3,958 | HBM3 80GB | 3.35 | 700 | 5.65 |
| H200 | 2024 | 3,958 | HBM3e 141GB | 4.8 | 700 | 5.65 |
| B200 | 2025 | 9,000 | HBM3e 192GB | 8.0 | 1,000 | 9.0 |
| Rubin R100 | 2026 | 25,000 | HBM4 288GB | 12.0 | 1,200 | 20.83 |
* A100은 FP16 312 TFLOPS/400W 기준
| 규격 | 연도 | 대역폭 (GB/s) | 스택당 용량 | 세대간 BW 향상 |
|---|---|---|---|---|
| HBM2e | 2020 | 460 | 16 GB | — |
| HBM3 | 2022 | 819 | 24 GB | 1.8x |
| HBM3e | 2024 | 1,200 | 36 GB | 1.5x |
| HBM4 | 2026 | 1,800 | 48 GB | 1.5x |
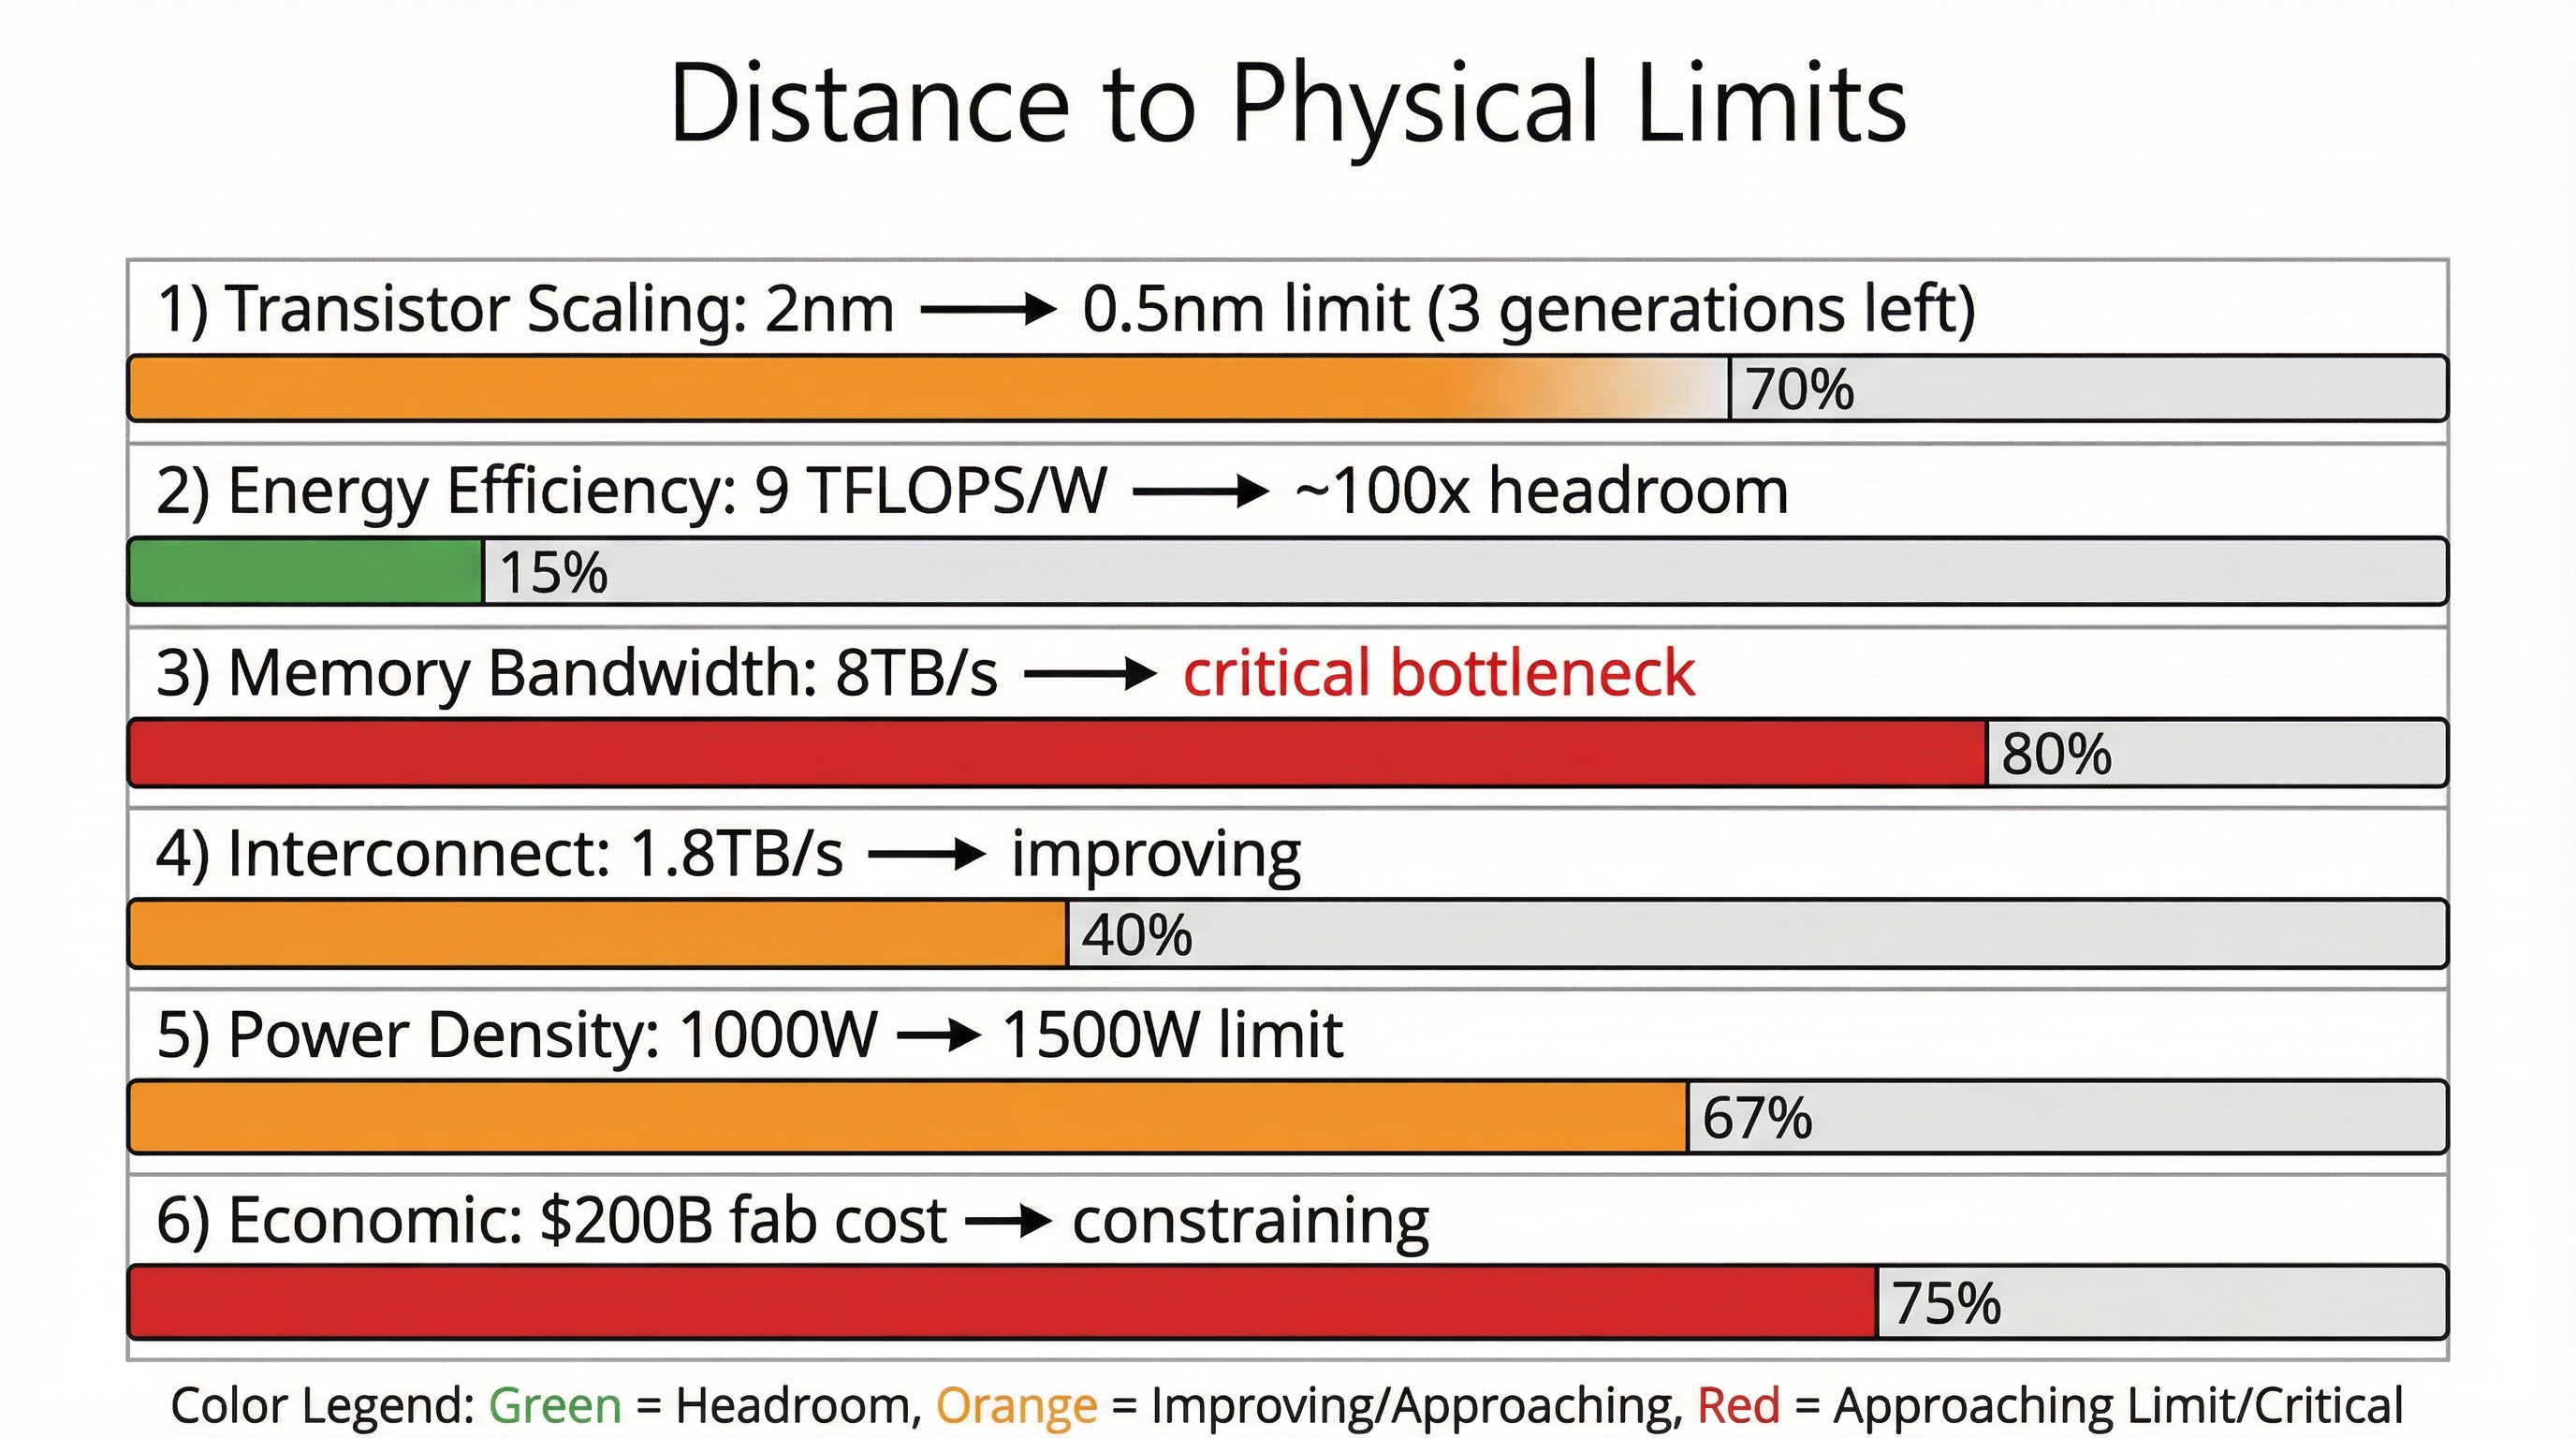
AI 하드웨어의 지속적 가속에 대한 6대 물리적 한계를 분석한다. 첫째, 트랜지스터 스케일링은 현재 2nm GAA 기술에서 약 3세대(~5년)의 여유만 남아 있다. TSMC N2 이후 A16(백사이드 전력공급), A14(1.4nm)를 거쳐 이론적 한계인 ~0.5nm에 근접한다. CFET(Complementary FET), 2D 소재(MoS2) 등 근본적 구조 변화가 필요하다.
둘째, 에너지 효율은 현재(B200 기준 9 TFLOPS/W)에서 란다우어 한계(kT ln2 ≈ 3×10⁻²¹ J/bit)까지 이론적으로 109배의 여유가 있다. 그러나 실용적 한계는 약 100배로, 매 세대 약 2배의 효율 향상이 지속되고 있다. 셋째, 메모리 대역폭이 가장 심각한 현재 병목이다. B200 기준 연산:메모리 비율이 1,125:1(FP8 9 PFLOPS / 8 TB/s)로, 대부분의 AI 워크로드가 메모리 바운드 상태다. HBM4(2026)로 12 TB/s까지 확대 예정이나 연산 성능 증가 속도를 따라가지 못한다.
넷째, 인터커넥트는 NVLink 5.0(1.8 TB/s)으로 세대당 약 2배 향상을 유지하나, 광속 지연(서버 간 ~5μs, 대륙 간 ~50ms)은 극복 불가능한 물리적 한계다. 다섯째, 전력 밀도는 B200의 1,000W에서 Rubin의 1,200W로 증가하며, 액침냉각(~3,000W+)이 냉각의 실질적 상한을 결정한다. 여섯째, 경제적 제약으로 최첨단 2nm 팹 건설비 $200억 이상, 프론티어 AI 모델 훈련 비용 $10억 이상이 소요되며, 비용의 지수적 증가가 진입장벽을 극단적으로 높이고 있다.
현재 주요 병목은 제조 계층(1.8x, 둔화 추세)이며, 숨은 병목은 메모리 대역폭이다. 이러한 병목에 대한 우회 전략으로 칩렛 아키텍처, 3D 적층(SoIC), Processing-in-Memory(PIM), 광인터커넥트 등이 적극 연구되고 있다. 특히 SK Hynix AiM과 Samsung HBM-PIM 프로토타입은 메모리 월(memory wall) 문제의 근본적 해결을 시도하는 사례다.
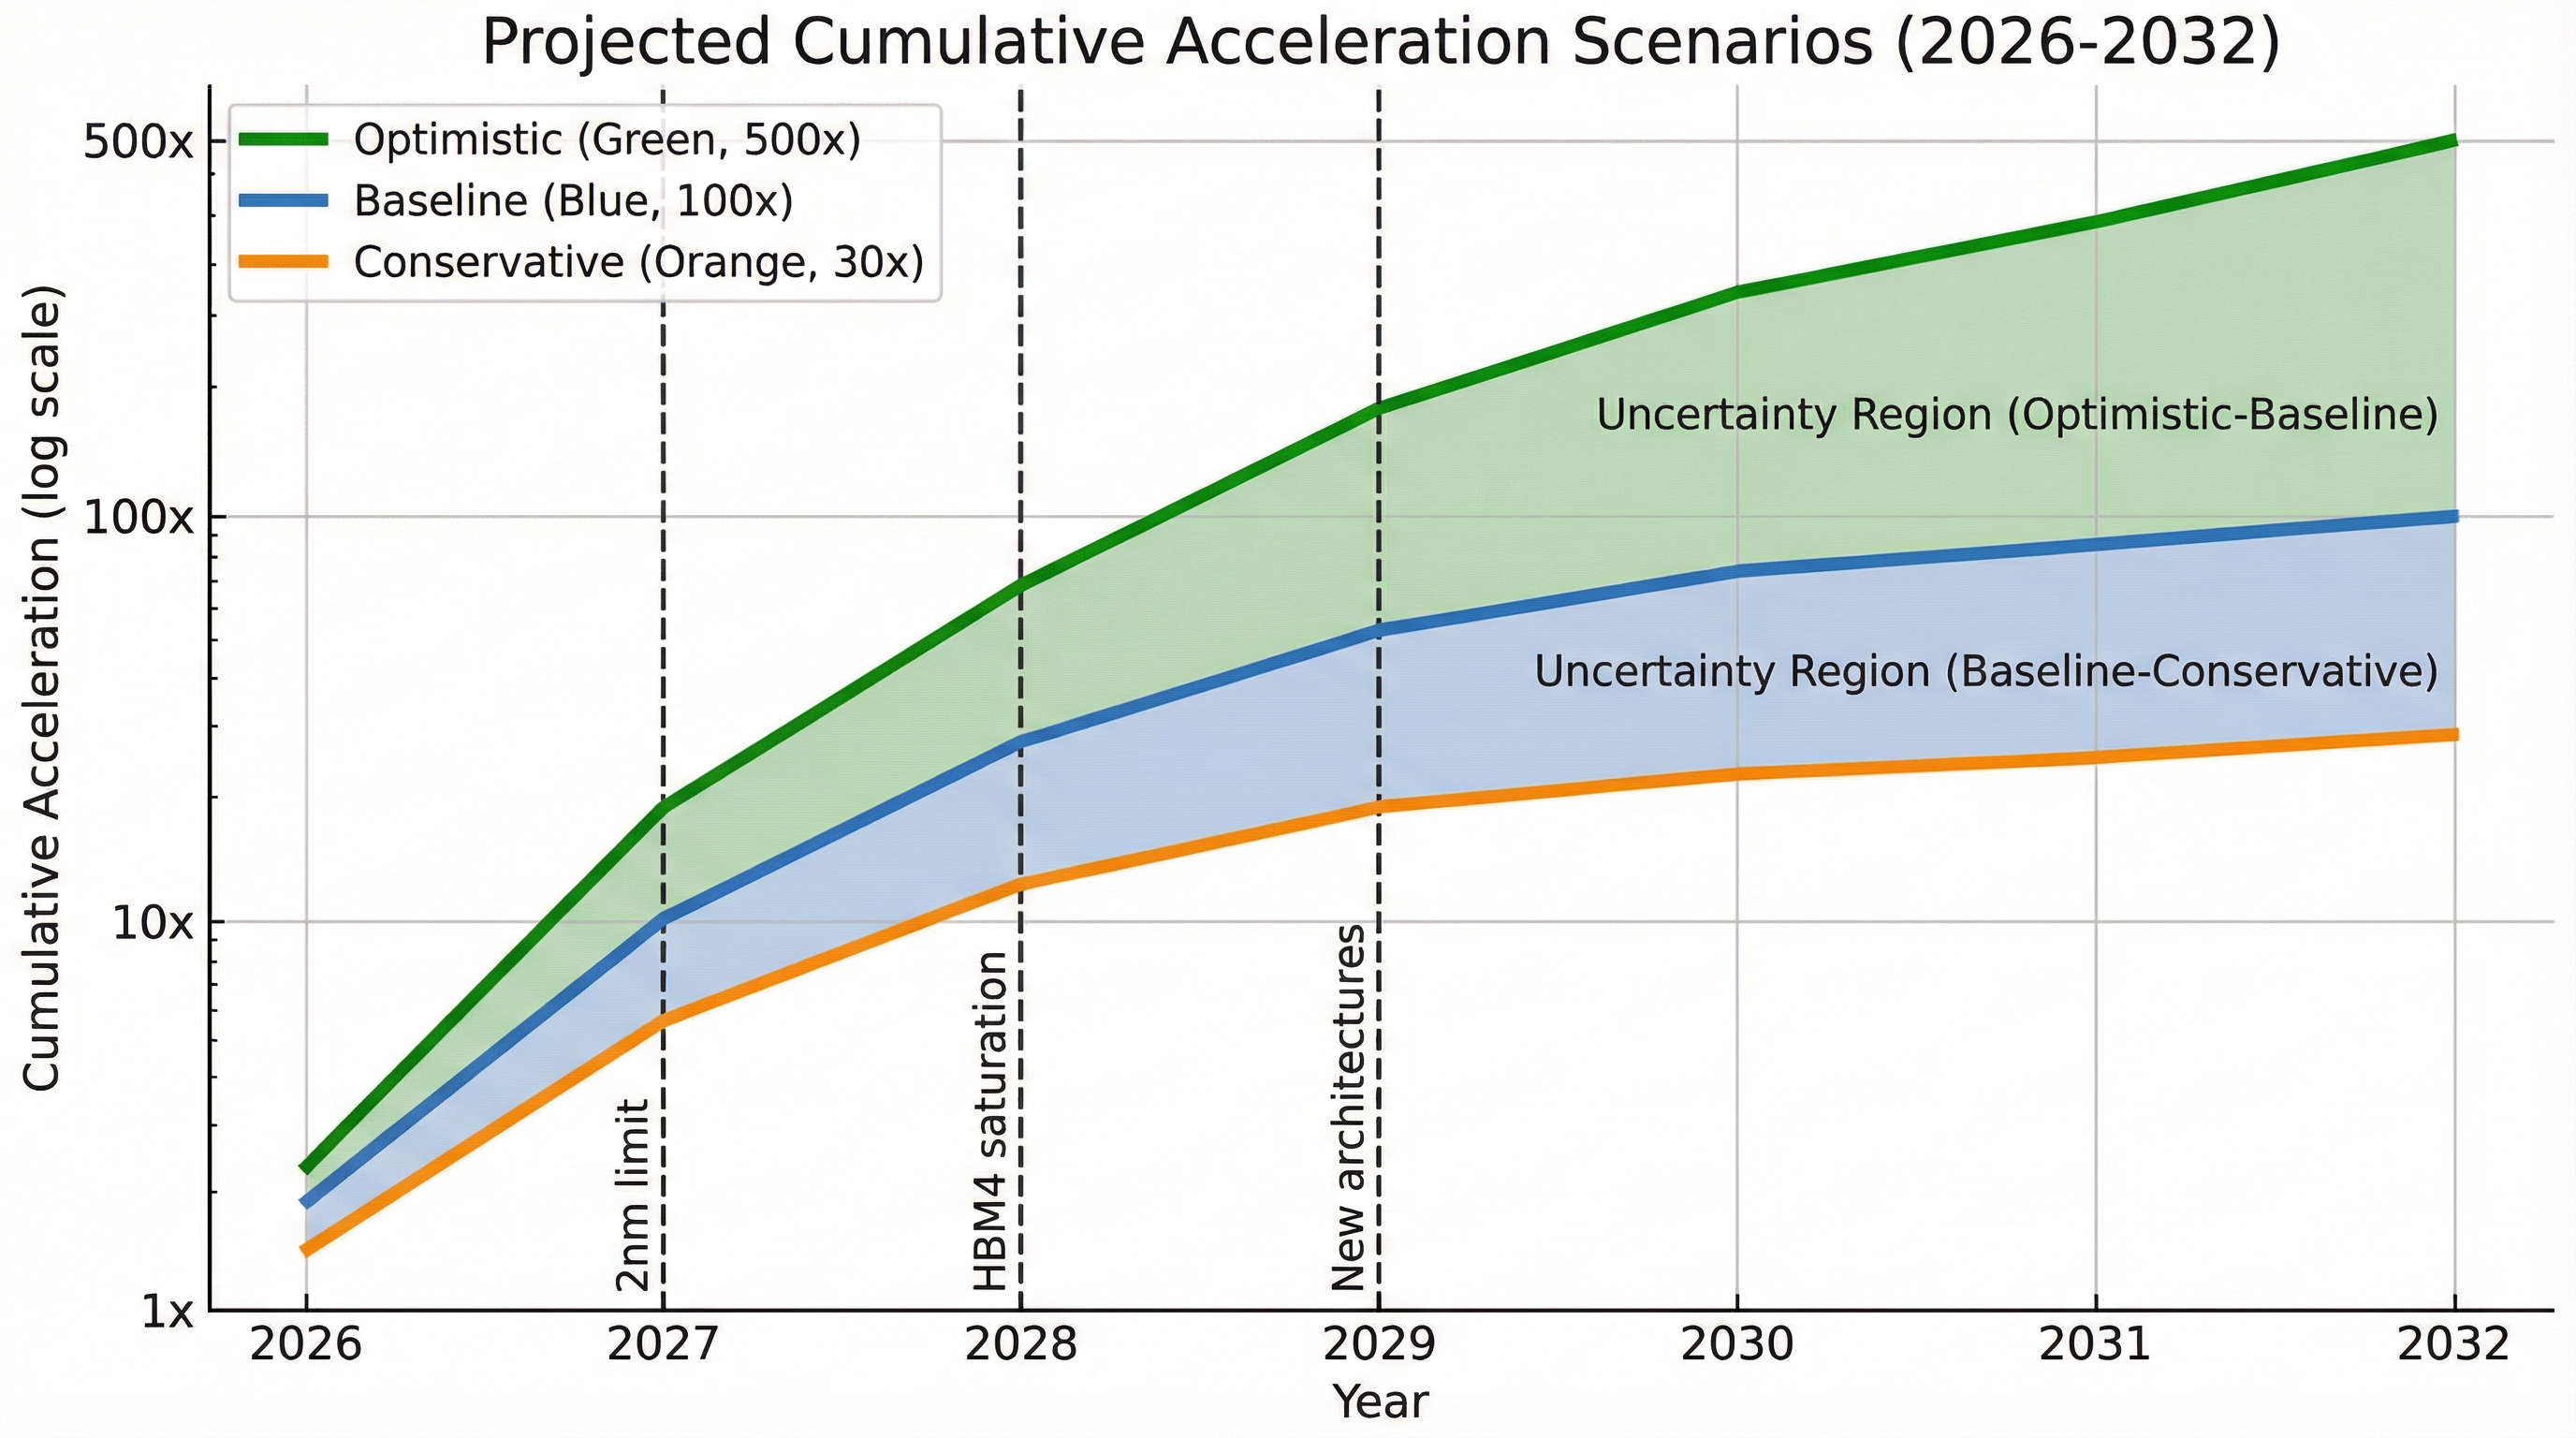
본 논문의 핵심 주장은 다음과 같다: 현재의 AI 하드웨어 재귀 가속 루프는 5대 계층 모두에서 실증되었으며, 소프트웨어(2.8x)와 알고리즘(4.0x) 계층의 급속 가속이 제조 계층(1.8x)의 둔화를 상쇄한다. 이 복합 재귀 구조는 향후 5–7년간 세대당 가속 배율이 현재(2.8x)보다 증가하여 3.5–5.0x에 도달하는 '초가속(Super-Acceleration)' 체제를 형성할 것이다.
이 전망을 세 가지 시나리오로 구체화한다. 낙관적 시나리오에서는 세대당 5.0x 가속으로 2032년까지 누적 500배의 성능 향상이 달성된다. 이 시나리오는 칩렛/3D 적층의 성공적 확산, AI-EDA의 완전 자동화, 그리고 알고리즘 효율의 지속적 개선을 전제한다. 기준선 시나리오에서는 세대당 3.5x 가속으로 2032년까지 누적 100배 향상을 예측한다. 이는 현재 추세의 완만한 가속을 반영한다. 비관적 시나리오에서는 세대당 2.0x로 둔화하여 누적 30배에 그치며, 이는 제조 병목의 심화와 경제적 제약의 강화를 가정한다.
초가속의 핵심 동력은 세 가지다. 첫째, AI-EDA 피드백 루프의 강화다. AlphaChip→TPU v5→v6→Ironwood로 이어지는 자기강화 루프가 각 세대마다 더 많은 설계 영역을 AI가 담당하며, 이 확장은 가속적이다. 둘째, 소프트웨어 최적화 공간의 확대다. ThunderKittens, TritonForge 등 AI가 직접 GPU 커널을 생성하는 기술의 등장은 소프트웨어 계층의 가속 잠재력이 아직 크게 남아있음을 시사한다. 셋째, 칩렛과 PIM 등 새로운 아키텍처가 제조 병목을 우회하는 경로를 제공한다.
한편, 초가속 전망에 대한 리스크도 존재한다. 경제적 집중의 심화로 상위 3사(NVIDIA, AMD, Google)가 AI 가속기 시장의 90% 이상을 지배하며, 최첨단 팹을 운영할 수 있는 기업은 TSMC, Samsung, Intel로 제한된다. 에너지 제약으로 데이터센터 전력 수요가 460 TWh에서 1,300 TWh로 급증하며, SMR 원자로 본격 가동까지 수년이 소요된다. 지정학적 불확실성으로 TSMC에 대한 의존도(최첨단 공정 점유율 90%+)가 공급망 리스크로 작용한다.
본 논문은 AI 하드웨어 발전의 재귀 가속 루프를 5대 계층—설계(3.2x), 제조(1.8x), 소프트웨어(2.8x), 인프라(2.0x), 알고리즘(4.0x)—으로 체계화하고, 각 계층의 실증 데이터를 분석했다. 현재 총 재귀 가속 배율은 세대당 2.8배이며 14개월 주기로 순환한다. NVIDIA A100에서 Rubin R100까지 5년간 에너지 효율 26.7배, Google TPU v4에서 Ironwood까지 4년간 연산 성능 16.7배의 향상이 실증적으로 확인되었다.
가장 주목할 발견은 소프트웨어(2.8x)와 알고리즘(4.0x) 계층의 급속 가속이 제조 계층(1.8x)의 물리적 둔화를 충분히 상쇄하고 있다는 점이다. 알고리즘 효율이 매년 약 2배 개선되는 추세는 동일 하드웨어에서 소프트웨어만으로 매년 2–3배의 성능 향상을 추출할 수 있음을 의미한다. 이는 트랜지스터 미세화의 한계에 관계없이 AI 성능 향상이 지속될 수 있는 구조적 근거를 제공한다.
향후 5–7년간 세대당 가속 배율이 현재의 2.8x에서 3.5–5.0x로 증가하는 '초가속' 체제가 형성될 것으로 전망한다. 이 전망의 핵심 근거는 AI-EDA 피드백 루프의 강화, 소프트웨어 최적화 공간의 확대, 그리고 칩렛/PIM 등 새로운 아키텍처의 등장이다. 제조 병목과 에너지 제약이 리스크 요인이나, 산업계의 대규모 투자($975B 반도체 매출, 10 GW+ 원자력 계약)가 이를 완화할 것이다.
AI가 자신의 하드웨어를 설계하는 재귀 루프—AlphaChip이 TPU를 설계하고, 그 TPU가 더 강력한 AlphaChip을 훈련시키는—는 기술사에서 유례없는 자기강화 메커니즘이다. 이 메커니즘이 5대 계층 전체에서 동시에 작동하고 있다는 사실은, 우리가 단순한 기술 발전의 연장선이 아닌 질적으로 새로운 가속 체제의 초입에 있음을 시사한다.